KI-Jobs über fünf Rechenzentren: OptaZEN plant voraus, der Scheduler führt aus
Welcher KI-Job läuft wann, wo und auf welchen GPUs, und was wird gemietet, damit wichtige Jobs pünktlich fertig werden, die eigenen GPUs belegt sind und wenig gemietet wird, während den ganzen Tag neue Jobs kommen und Knoten ausfallen?
Ergebnis im Beispiel, verglichen mit „Scheduler mit Team-Kontingenten“: Miete on demand 0 € statt 1.000 €, Miete Spot 437 € statt 6.704 €.
Unternehmen mit eigenen GPU-ClusternRechenzentren in der ForschungKI- und Machine-Learning-TeamsGPU-Clouds und Rechenzentrumsbetreiber
Ziehen dreht, Ziehen mit rechter Maustaste oder mit Umschalttaste verschiebt die Karte, Scrollen oder Zwei-Finger-Geste zoomt. Jedes Rack hat 64 GPUs; seine acht Lichter zeigen die Jobs auf seinen Knoten: blau Inferenz, lila Training, orange Fine-Tuning, türkis Batch, grün Experimente, rot ein ausgefallener Knoten. Oben im Plan: die GPUs im Einsatz (grün eigene, rot on demand, gelb Spot, gestrichelt die eigene Kapazität), die Warteschlange und die Ereignisse (lila eine Neuplanung des Meta-Planers, rot ein Knotenausfall). Zum Vergleich auf den Scheduler allein umschalten; Balken zeigen Details beim Überfahren.
Die Planungsfrage
Unternehmen und Forschungszentren betreiben GPUs in mehreren Rechenzentren und mieten zusätzliche Kapazität in der Cloud. Ihr Scheduler (Slurm oder Kubernetes) entscheidet in Sekunden, welcher Job auf freien GPUs startet. So wie er meist eingerichtet ist, plant er wenig voraus und selten über Standorte und Preise hinweg: Große Jobs warten auf Lücken, jedes Team bleibt in seinem Rechenzentrum, und wird die Warteschlange lang, wird gemietet.
Hier plant der Meta-Planer von OptaZEN vor dem Scheduler. Alle 30 Minuten schaut er 24 Stunden voraus und entscheidet für jeden bekannten Job, wo und wann er läuft, welche laufenden Jobs kurz pausieren und was gemietet wird. Der Scheduler führt den Plan aus. Über fünf simulierte Tage werden 98 % statt 95 % der wichtigen Jobs pünktlich fertig, die eigenen GPUs sind zu 86 % statt 82 % belegt, und die Miete sinkt von rund 7.000 € auf rund 300 € je Tag. Bei dieser Flotte sind das rund 380 GPUs mehr im Einsatz und etwa 2 Mio. € weniger Miete im Jahr, ohne neue Hardware. Die erledigte Arbeit schwankt von Tag zu Tag: An zwei der fünf Tage, auch am hier gezeigten, schafft der Plan weniger Training als der Vergleich.
Das Beispiel ist eine fiktive Zusammenstellung: Rechenzentren, Flotten, Preise, Jobs und Leistungswerte sind erfunden, die GPU-Namen (NVIDIA A100 bis B200, AMD MI250X, MI300X) bezeichnen nur den Hardwaretyp, und es gibt keine Verbindung zu einem Hersteller oder Anbieter. Fünf Rechenzentren betreiben 9.728 GPUs in Racks zu 64. An einem Dienstag schicken die Teams 863 Jobs: reservierte Inferenz, zehn lange Trainingsläufe, 56 Fine-Tuning-Jobs mit Fristen wenige Stunden nach dem Einreichen, 130 Batch-Jobs und 600 Experimente, mehr als hineinpasst. Der Tag wird simuliert: Jobs werden erst beim Einreichen bekannt, laufen kürzer als geschätzt, Knoten fallen aus, und die Cloud hat kurzfristig nur begrenzt Kapazität.
So planen wir
Der Meta-Planer plant vom aktuellen Zustand aus: Laufende Jobs behalten ihre Racks, ausgefallene Knoten sind gesperrt, Inferenz bleibt reserviert. GPUs je Rack sind eine harte Regel; danach zählen Fristen; dann Euro: die Miete, der Wert liegen gebliebener Arbeit (angenommen 2 € je A100-Stunde für Training, 1 € für Experimente), das Verschieben von Daten und kleine Kosten für jede Änderung gegenüber dem letzten Plan, damit der Plan ruhig bleibt. Er kopiert die Daten eines Jobs vor seinem Start und plant mit einer vorsichtigen Prognose der Laufzeiten. Der Plan geht als Reservierungen, Startzeiten und Pausen an den Scheduler.
Verglichen wird mit dem Scheduler allein, eingerichtet wie verbreitet: jedes Team in seinem Heimat-Rechenzentrum, Priorität, dann Reihenfolge des Eingangs, Backfill, keine Pausen; ein Job, der eine Stunde gewartet hat oder seine Frist verpassen würde, wird gemietet. Beide laufen an denselben simulierten Tagen mit denselben Jobs, Laufzeiten und Ausfällen. Der Meta-Planer bekommt 12 Sekunden je Neuplanung. Jeder Plan ist der beste aus dieser Zeit. Ob es einen noch besseren gibt, ist nicht bewiesen.
Was der Plan zeigt
| Kennzahl | Optimierter Plan | Vergleich: Scheduler mit Team-Kontingenten |
|---|---|---|
| wichtige Jobs pünktlich | 97,8 % +1,2 | 96,6 % |
| eigene GPUs belegt | 84,5 % +3 | 81,5 % |
| Miete on demand | 0 € −1.000 | 1.000 € |
| Miete Spot | 437 € −6.267 | 6.704 € |
| Experimente fertig | 526 +2 | 524 |
Entscheidungen
- Platz jedes Jobs: Rechenzentrum, GPU-Generation und Racks, oder die Cloud (on demand oder Spot)
- Start jedes Jobs und kurze Pausen laufender Jobs mit Checkpoints
- alle 30 Minuten neu für die nächsten 24 Stunden, als Vorgabe für den Scheduler
Randbedingungen
- alle GPUs eines Jobs zugleich, nah beieinander, mit genug Speicher
- Fristen und Prioritäten: Inferenz reserviert, dann Fristen, dann der Rest
- Spot nur für Jobs mit Checkpoints, Experimente nur auf eigenen GPUs
Ziel
wichtige Jobs pünktlich, danach wenig Miete und viel erledigte Arbeit auf den eigenen GPUs
Fragen
Sind die Rechenzentren, Preise und Werte echt?
Nein. Rechenzentren, Flotten, Mieten, Jobs, Teams und Leistungswerte sind eine fiktive Zusammenstellung. NVIDIA und AMD bezeichnen nur den GPU-Typ. Es gibt keine Verbindung zu einem Hersteller, Betreiber oder Cloud-Anbieter.
Warum bleibt der Scheduler?
Er läuft im Betrieb, reagiert in Sekunden auf jeden fertigen Job und jeden ausgefallenen Knoten und kennt die Details der Maschinen. Ihn zu ersetzen wäre ein Risiko ohne Nutzen. Was ihm fehlt, sind der Blick voraus und die Kosten über Standorte hinweg. Genau das ergänzt der Meta-Planer, und ohne den Plan läuft alles weiter wie bisher.
Worin unterscheiden sich Scheduler und Planungsebene?
Der Scheduler fragt: Welcher wartende Job passt auf die GPUs, die jetzt frei sind? Er folgt festen Regeln: Priorität, Kontingente, erster freier Platz, ein Cluster. Die Planungsebene fragt: Was ist der beste Plan für alle bekannten Jobs über die nächsten 24 Stunden? Sie wägt Fristen, Miete und den Wert der Arbeit über alle Rechenzentren und die Cloud ab, entscheidet Pausen und kopiert Daten vorab. An diesem Tag geht kein Fine-Tuning-Job in die Cloud, und weniger wichtige Jobs sind zu spät.
Wie kommt der Meta-Planer in die Architektur?
Alle 30 Minuten liest er den Zustand aus dem Scheduler: Warteschlange, laufende Jobs, ausgefallene Knoten. Er plant und schreibt das Ergebnis zurück: bei Slurm als Reservierungen, Startzeiten und Prioritäten, bei Kubernetes als Kontingente der Warteschlangen und Ziel-Cluster eines Jobs. Eine Pause ist ein Checkpoint-Signal. Er startet im Schattenbetrieb neben dem Scheduler, gibt dann Empfehlungen, die ein Mensch bestätigt, und steuert danach.
Könnte der Meta-Planer selbst der Scheduler sein?
Für kleinere Cluster oder Batch-Arbeit, bei der eine Entscheidung innerhalb einer Minute reicht: ja, das Planungsmodell kann nach jedem Ereignis in Sekunden neu planen. Bei großen Clustern ist die Aufteilung besser: Der Scheduler übernimmt die Arbeit an den Maschinen im Sekundentakt, der Meta-Planer den Plan.
Warum mietet der Vergleich nur 1.000 € on demand?
Er mietet Spot, sobald ein Job Checkpoints schreibt: 6.704 € an diesem Tag. Nur Fine-Tuning, das keine Checkpoints schreibt, geht on demand, und diese Jobs sind klein. Der Plan mietet fast nichts, weil er Fine-Tuning auf freie GPUs in anderen Rechenzentren legt und die Daten vorab kopiert.
Warum ein Planungsmodell?
Die Regeln sind zahlreich und von Unternehmen zu Unternehmen verschieden: Topologie, Speicher, Fristen, Kontingente, Preise, Wartung. Ein Planungsmodell beschreibt sie als Regeln mit Gewichten, findet gute Pläne in Sekunden, erklärt einen Plan über seine Bewertung und läuft im eigenen Rechenzentrum.
Wie sähe ein Pilot aus?
Einige Wochen Ihrer Job-Historie kalibrieren die Simulation. Dann läuft die Planung im Schattenbetrieb neben Ihrem Scheduler, und beide werden an denselben Tagen verglichen, bevor sie empfiehlt oder steuert.
Weitere Anwendungsfälle
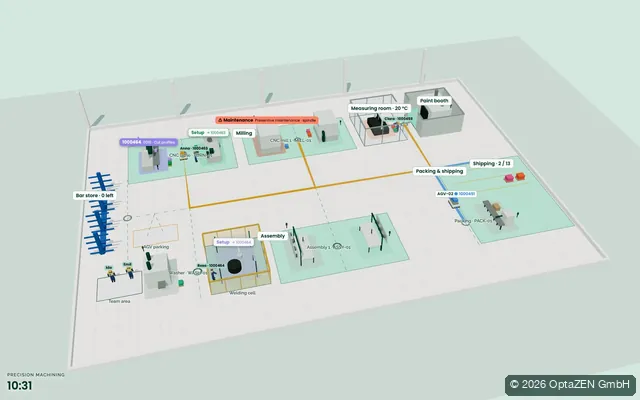
Produktionsplanung Zerspanung
CNC-Fräsen, Drehen, Schweißen und Montage; Komponentenaufträge versorgen die Montage, FTS fahren das Material, Mitarbeitende in Schichten.
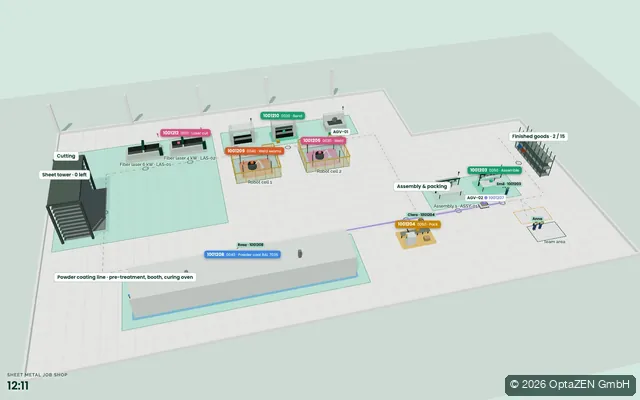
Produktionsplanung Blechbearbeitung
Laserschneiden, Kanten, Roboterschweißen und eine Pulverbeschichtung, die in Farbchargen läuft.
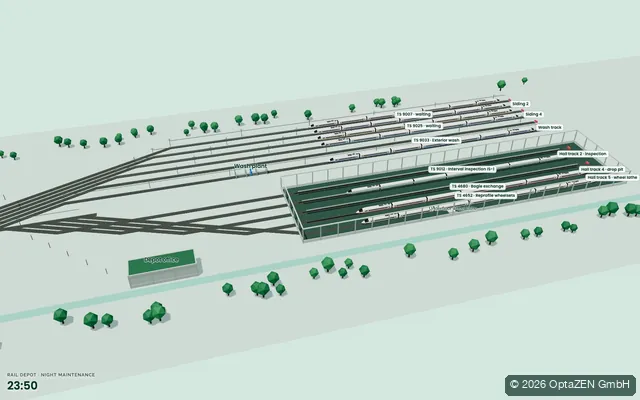
Bahnwerk Nachtinstandhaltung
Waschanlage, Untersuchungsgruben, Achssenke und Unterflurdrehmaschine; ein Rangierteam bewegt die Züge durch die Weichenstraße.
Der erste Schritt
Wo verliert Ihre Planung Zeit, Kapazität oder Geld?
Im kostenlosen Erstgespräch klären wir, welcher nächste Schritt sich wirklich lohnt.